For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/claude-haiku-5-vs-gpt-6-luna-benchmarks-p-ec36c306.md.
Anthropic a lancé **Claude Haiku 5.5**, et il ne s’agit pas d’une simple mise à jour d’un petit modèle.

Anthropic a lancé Claude Haiku 5.5, et il ne s’agit pas d’une simple mise à jour d’un petit modèle.
Le nouveau Haiku dépasse largement Haiku 4.5 en matière d’utilisation d’ordinateurs, de développement, de tâches professionnelles et d’agents utilisant de nombreux outils, tout en réduisant fortement son tarif API affiché.
Dans les propres comparaisons de lancement d’Anthropic, Haiku 5.5 surpasse également GPT-6 Luna sur plusieurs benchmarks, notamment GDPval-AA v2.1, OSWorld 2.1, Terminal-Bench 4.0, FrontierCode 1.1 et Chartography.
Haiku 5.5 devient donc une nouvelle option sérieuse pour les charges de travail à grande échelle, telles que :
Mais ce lancement s’accompagne également de réserves importantes.
La tarification change à partir du seuil de 100K tokens d’entrée, le tokenizer utilise davantage de tokens pour un même texte et la mise à niveau d’une intégration Haiku 4.5 existante nécessite plusieurs modifications de l’API.
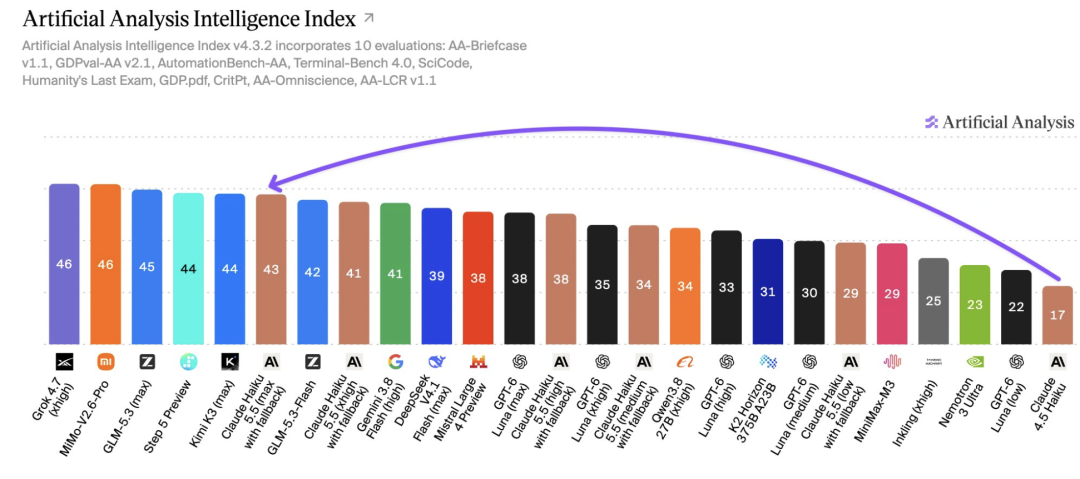
Anthropic présente Haiku 5.5 comme son petit modèle le moins cher, le plus rapide et le plus performant à ce jour.
Le tableau officiel des benchmarks rend le concurrent visé évident : GPT-6 Luna est placé directement à côté de Haiku 5.5.
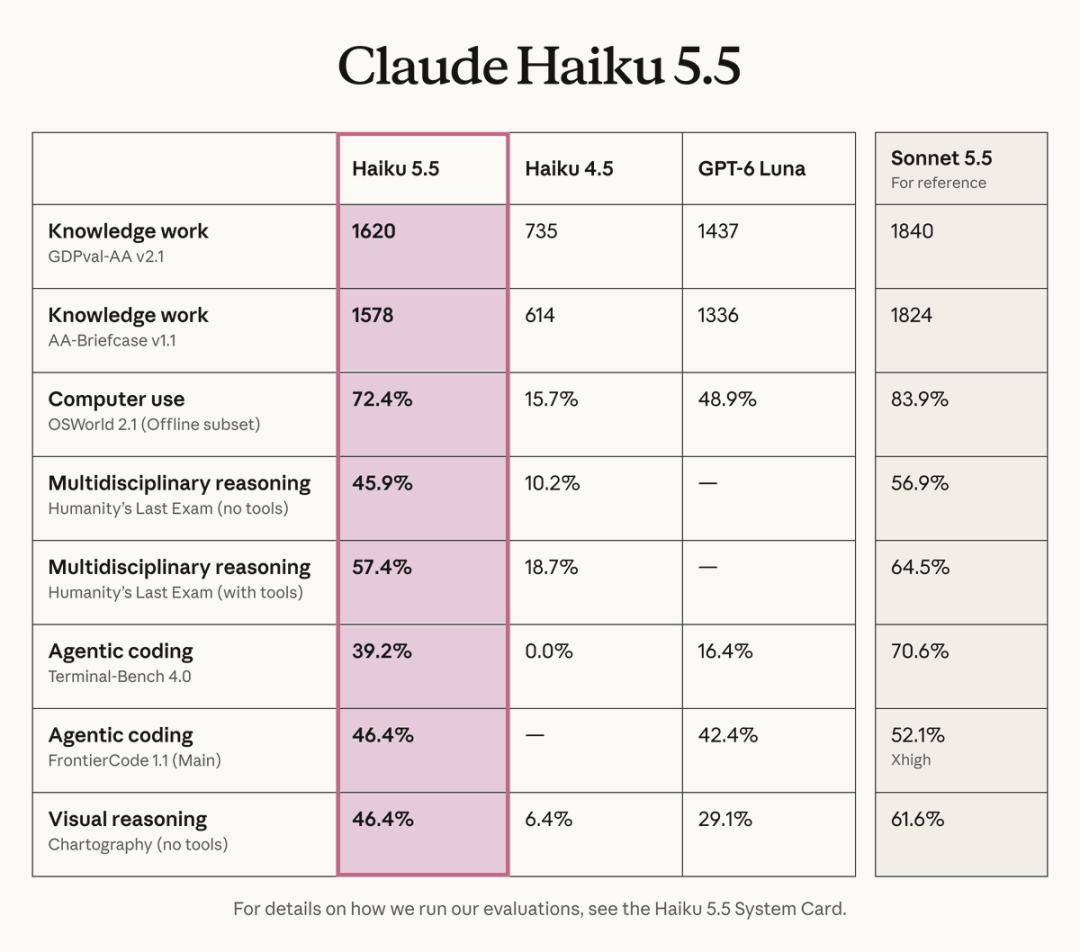
Les résultats du lancement sont les suivants :
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, sous-ensemble hors ligne | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| Humanity’s Last Exam, sans outils | 45,9 % | 10,2 % | — | 56,9 % |
| Humanity’s Last Exam, avec outils | 57,4 % | 18,7 % | — | 64,5 % |
| Terminal-Bench 4.0 | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| FrontierCode 1.1 (Main) | 46,4 % | — | 42,4 % | 52,1 % |
| Chartography, sans outils | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
La conclusion n’est pas que Haiku 5.5 remplace soudainement tous les modèles plus grands.
C’est plutôt que le niveau Claude le plus compact est devenu beaucoup plus performant pour les types de tâches qui nécessitaient auparavant un modèle plus imposant.
Pour les prompts allant jusqu’à 100K tokens, Anthropic facture :
Entrée Haiku 5.5 :        0,10 $ / 1 M de tokens
Sortie Haiku 5.5 :        0,50 $ / 1 M de tokens
Lecture du cache :        0,01 $ / 1 M de tokens
Écriture du cache :       0,125 $ / 1 M de tokens
La tarification standard actuelle d’OpenAI pour GPT-6 Luna est la suivante :
Entrée GPT-6 Luna :             0,10 $ / 1 M de tokens
Entrée GPT-6 Luna mise en cache : 0,01 $ / 1 M de tokens
Écriture du cache GPT-6 Luna :   0,125 $ / 1 M de tokens
Sortie GPT-6 Luna :             0,50 $ / 1 M de tokens
Pour les tâches API standard avec un contexte court, les deux modèles sont donc presque parfaitement alignés sur les tarifs unitaires affichés.
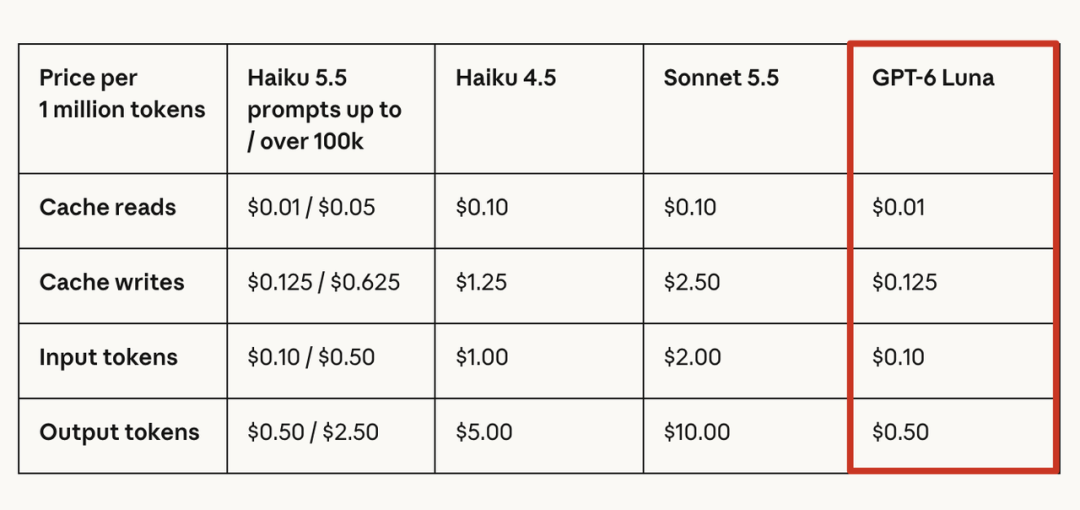
Haiku 5.5 utilise deux niveaux de tarification.
| Type de token | Prompt ≤100K | Prompt >100K |
|---|---|---|
| Lecture du cache | 0,01 $/M | 0,05 $/M |
| Écriture du cache | 0,125 $/M | 0,625 $/M |
| Entrée | 0,10 $/M | 0,50 $/M |
| Sortie | 0,50 $/M | 2,50 $/M |
Anthropic indique que les prompts allant jusqu’à 100K tokens représentaient environ 90 % des requêtes Haiku 4.5, ce qui explique pourquoi le niveau inférieur couvre la majorité du trafic attendu.
Pour les prompts dépassant 100K, Haiku 5.5 reste moins cher que Haiku 4.5, mais l’écart de prix est plus limité.
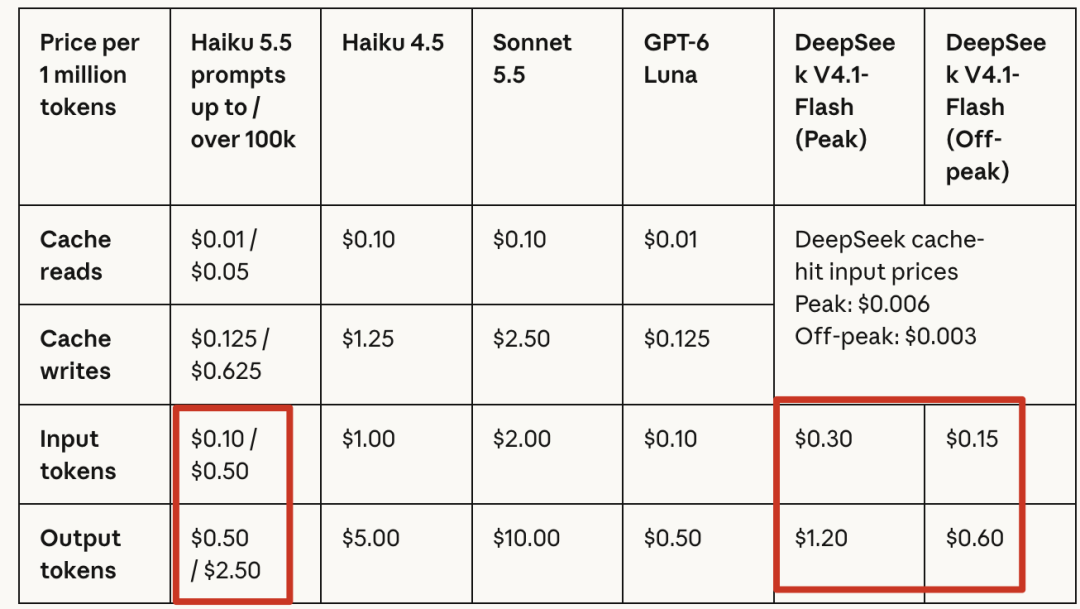
L’article source compare Haiku 5.5 à DeepSeek-V4.1-Flash.
La tarification officielle actuelle de DeepSeek utilise des tarifs de pointe et des tarifs hors pointe.
Pour l’entrée sans correspondance dans le cache et la sortie :
| Modèle | Entrée / 1 M | Sortie / 1 M |
|---|---|---|
| Haiku 5.5, prompt ≤100K | 0,10 $ | 0,50 $ |
| DeepSeek-V4.1-Flash, hors pointe | 0,15 $ | 0,60 $ |
| DeepSeek-V4.1-Flash, pointe | 0,30 $ | 1,20 $ |
DeepSeek reste moins cher pour l’entrée correspondant au cache, en particulier hors pointe. Le coût total dépend donc toujours de la structure de la charge de travail.
La génération précédente de Haiku n’était pas compétitive sur les tâches exigeantes d’utilisation d’un ordinateur.
Haiku 5.5 change radicalement la donne.
Le résultat obtenu par Anthropic sur le sous-ensemble hors ligne d’OSWorld 2.1 passe de 15,7 % pour Haiku 4.5 à 72,4 % pour Haiku 5.5 avec un effort maximal.
L’article source a également réalisé un test pratique : il a demandé à Haiku 5.5 d’ajouter les données tarifaires de GPT-6 et de DeepSeek au tableau de la page de lancement de Haiku.
Au lieu de modifier manuellement chaque élément HTML via l’interface, le modèle a ouvert la console du navigateur et injecté les changements à l’aide d’un script.
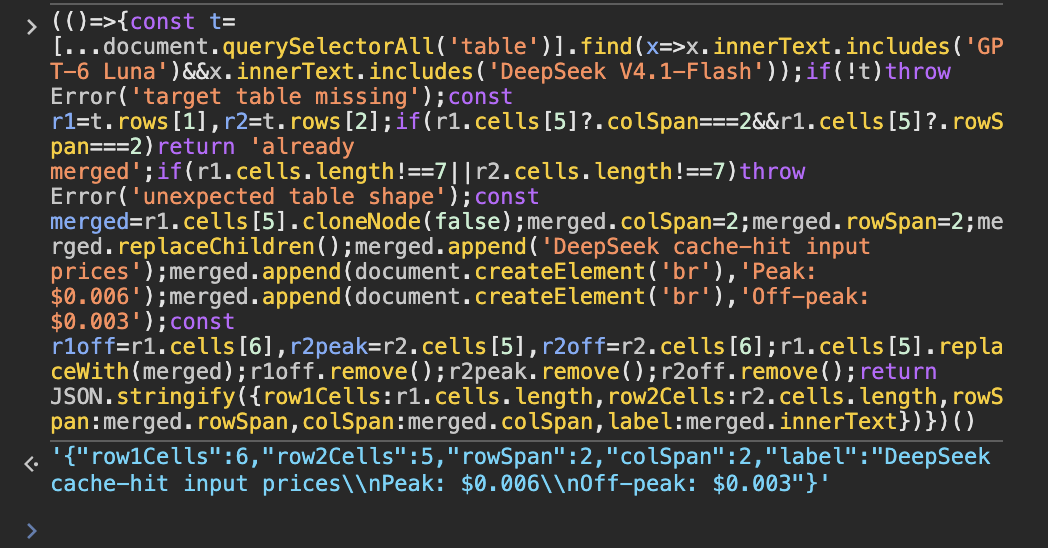
Ce comportement est utile, car les agents capables d’utiliser un ordinateur n’ont pas toujours besoin d’imiter littéralement les mouvements d’une souris humaine.
Si l’environnement du navigateur expose une voie d’exécution plus directe, l’utilisation d’un script peut être plus rapide et plus fiable que le fait de cliquer sur chaque cellule.
Haiku 5.5 est le premier modèle de la famille Haiku à proposer un contrôle réglable de l’effort.
Le modèle prend en charge un éventail de comportements allant d’une exécution moins coûteuse et plus rapide à un raisonnement plus cher et plus réfléchi.
Le graphique de lancement d’Anthropic montre une courbe claire entre précision et coût sur OSWorld.
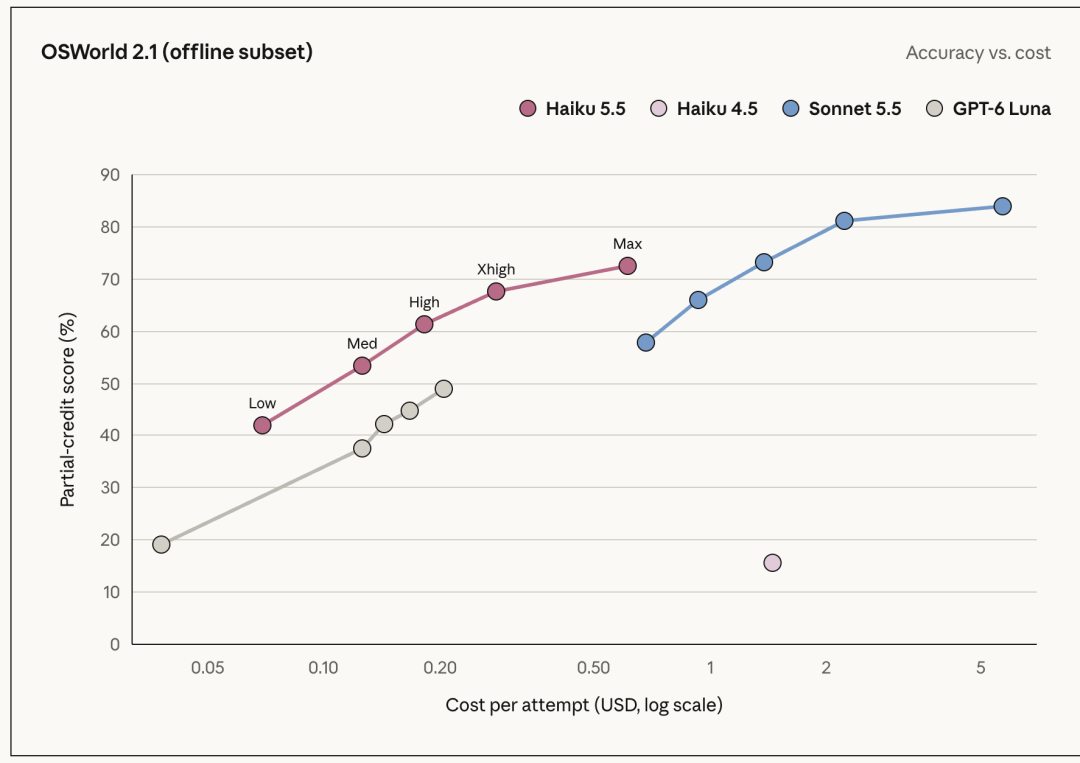
La source met en avant deux points de cette courbe :
Le coût exact d’une tâche en production varie selon la longueur du prompt, la longueur de la sortie, la mise en cache et l’utilisation d’outils, mais la tendance générale est importante.
Vous pouvez désormais régler Haiku en fonction de la tâche, au lieu de considérer un « petit modèle » comme un niveau de capacité fixe.
GDPval-AA v2.1 mesure des tâches professionnelles réelles dans 44 professions.
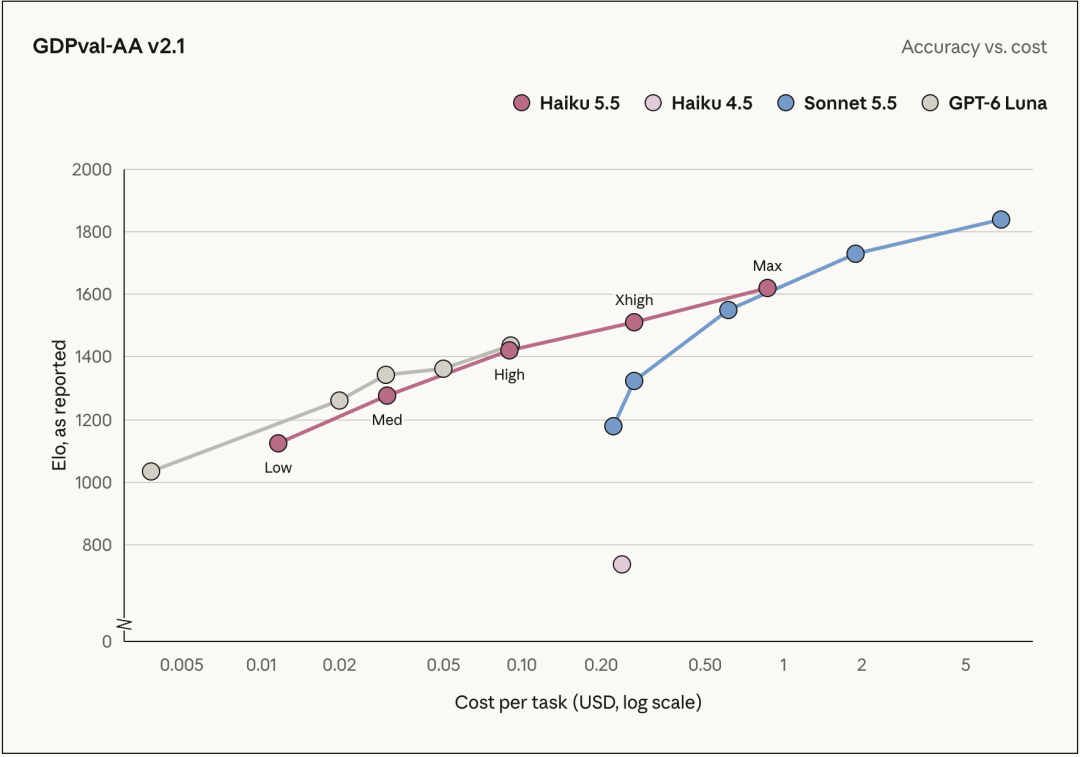
Avec un effort maximal, Anthropic indique un score Elo de 1620 pour Haiku 5.5, contre 735 pour Haiku 4.5.
Une fois encore, Sonnet 5.5 reste plus performant, mais l’écart entre « petit » et « réellement utile dans un contexte professionnel » s’est fortement réduit.
Haiku 5.5 introduit un tokenizer plus récent, partagé avec les nouvelles générations de Claude.
Cela compte, car un même texte ne produit pas le même nombre de tokens qu’avec Haiku 4.5.
Le guide de migration d’Anthropic indique qu’un même texte d’entrée produit environ 30 % de tokens supplémentaires avec Haiku 5.5 par rapport à Haiku 4.5, même si l’augmentation exacte dépend du contenu.
L’impact peut être plus important ou plus faible selon la charge de travail. Le code, les tableaux et les textes non anglophones méritent notamment d’être réévalués.
La comparaison suivante est donc trop simpliste :
Ancien tarif d’entrée : 1,00 $
Nouveau tarif d’entrée : 0,10 $
Donc chaque tâche coûte exactement 90 % moins cher
Le calcul le plus pertinent est le suivant :
coût réel de la tâche
= nouveau nombre de tokens
× nouveau tarif par token
+ coût du cache
+ coût de sortie
+ coût des outils
Anthropic indique lui-même qu’après prise en compte des changements du tokenizer, Haiku 5.5 coûte en moyenne environ 75 % moins cher que Haiku 4.5, et non pas 90 % de moins pour chaque tâche.
Artificial Analysis montre également pourquoi l’efficacité en tokens compte lors de la comparaison de modèles peu coûteux.
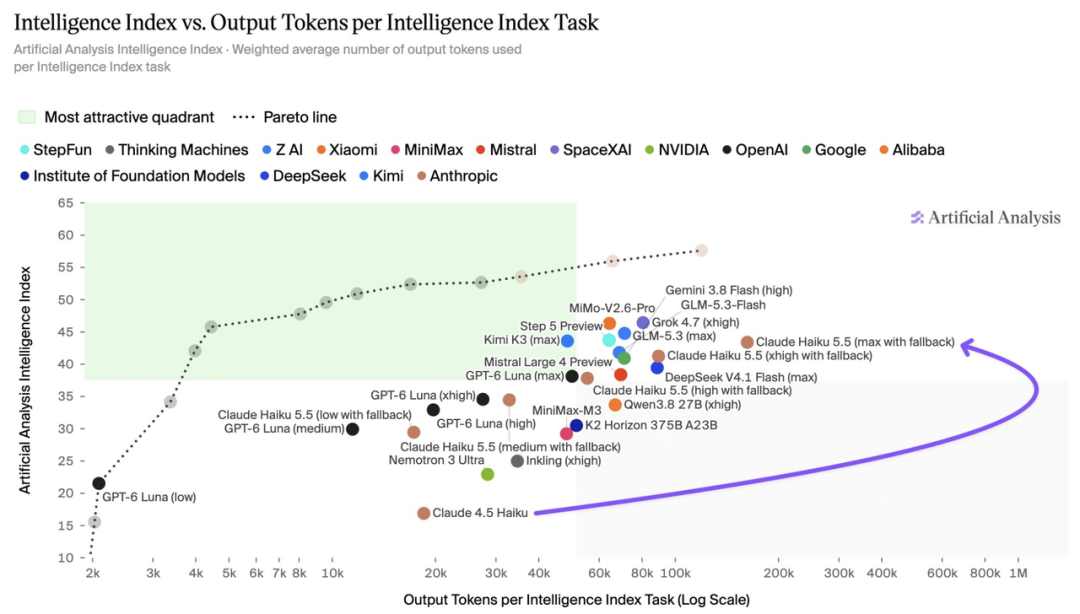
Un modèle peut afficher un faible tarif par token tout en utilisant beaucoup plus de tokens pour terminer une tâche.
Pour les systèmes en production, le coût par tâche terminée est plus utile que le seul prix par million de tokens.
L’article source le souligne clairement : la « petite tasse » reste une petite tasse.
Haiku 5.5 est nettement plus performant que Haiku 4.5, mais le développement autonome complexe reste une tâche à confier à un modèle plus grand.
Terminal-Bench 4.0 montre l’écart :
Haiku 5.5 :  39,2 %
Sonnet 5.5 : 70,6 %
Anthropic recommande explicitement Sonnet 5.5 ou Opus 5.5 pour le développement agentique complexe.
Haiku 5.5 est mieux adapté aux tâches dont le périmètre est déjà bien défini :
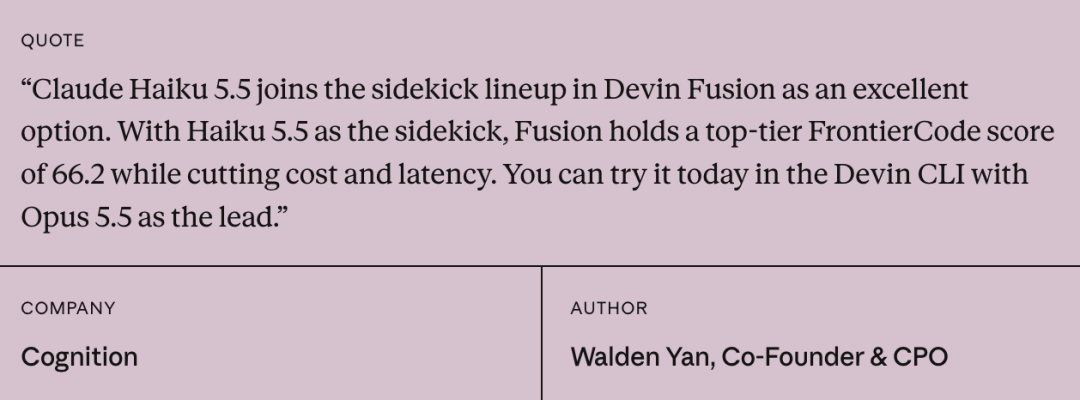
Cognition utilise déjà cette structure dans Devin Fusion.
La page de lancement indique qu’Opus 5.5 peut agir comme responsable, tandis que Haiku 5.5 travaille comme assistant.
Cette combinaison a atteint un score FrontierCode de 66,2 dans la configuration rapportée par Cognition, tout en réduisant le coût et la latence.
Le modèle est simple :
Opus / Sonnet
→ planification, décomposition, décisions complexes

Haiku 5.5
→ sous-tâches ciblées, exécution parallèle, recherches rapides, synthèses
Il s’agit probablement d’une manière plus réaliste d’utiliser Haiku 5.5 que d’essayer de remplacer partout un modèle plus puissant.
Si une application utilise déjà Haiku 4.5, Anthropic avertit que plusieurs changements peuvent interrompre les requêtes existantes.
L’identifiant officiel du modèle est désormais :
claude-haiku-5-5
Mais la migration comporte plusieurs exigences supplémentaires.
Une requête Haiku 4.5 comme celle-ci n’est plus valide :
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Haiku 5.5 utilise à la place le raisonnement adaptatif et les contrôles d’effort :
{
  "thinking": {
    "type": "adaptive"
  },
  "output_config": {
    "effort": "medium"
  }
}
Une requête qui envoie l’ancien format budget_tokens renvoie une erreur 400.
Le raisonnement adaptatif est également activé par défaut. Les applications ne doivent donc pas supposer que le premier bloc de contenu de la réponse contient toujours le texte normal de la réponse.
Analysez les blocs selon leur type.
max_tokensComme le nouveau tokenizer compte le même texte comme un nombre supérieur de tokens, les anciennes valeurs de max_tokens peuvent ne plus laisser assez de place pour produire une sortie équivalente.
Les tokens de raisonnement sont également comptabilisés dans le budget de sortie.
Recomptez les prompts avec claude-haiku-5-5 au lieu de réutiliser les estimations de tokens de Haiku 4.5.
Haiku 5.5 ne prend plus en charge les paramètres d’échantillonnage arbitraires de la même manière que Haiku 4.5.
Anthropic recommande d’omettre :
temperature
top_p
top_k
Les valeurs non définies par défaut peuvent produire des erreurs 400, et top_k n’est pas accepté.
Les applications qui utilisaient des paramètres d’échantillonnage pour introduire de la variation créative doivent déplacer ce contrôle vers les prompts ou vers une autre stratégie au niveau de l’application.
Haiku 4.5 pouvait poursuivre une réponse à partir d’un message final de l’assistant dans certaines configurations.
Haiku 5.5 rejette le préremplissage de l’assistant.
Si vous utilisiez auparavant un préfixe tel que :
{"result":
pour forcer une sortie JSON, migrez plutôt vers des sorties structurées ou un schéma d’outil.
Pour les intégrations Claude API et Google Cloud, l’ancienne déclaration d’utilisation de l’ordinateur :
computer_20250124
doit être remplacée par :
computer_toolset_20260801
Le nouvel ensemble d’outils possède une structure d’événements différente. La boucle de l’agent doit donc distribuer correctement les blocs tool_use renvoyés et conserver toolset_name dans les résultats.
Haiku 5.5 prend également en charge l’ensemble d’outils d’utilisation du navigateur d’Anthropic pour les tâches liées aux pages web sur les plateformes compatibles.
Avant de déployer Haiku 5.5, vérifiez au moins les éléments suivants :
claude-haiku-5-5.budget_tokens par le raisonnement adaptatif et le contrôle de l’effort.type au lieu de supposer que le bloc zéro contient le texte de réponse.computer_toolset_20260801 lorsque cela est nécessaire.refusal.Anthropic fournit également une commande automatisée de migration Claude Code :
/claude-api migrate this project to claude-haiku-5-5
L’outil peut appliquer les changements d’identifiant du modèle et détecter plusieurs formats de requête incompatibles, mais une vérification manuelle reste recommandée.
Haiku 5.5 n’est pas la seule évolution tarifaire annoncée par Anthropic.
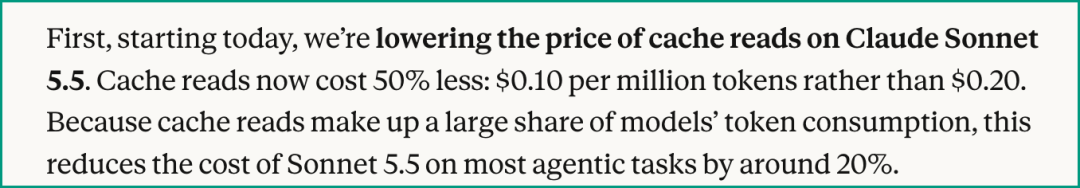
Le tarif de lecture du cache de Sonnet 5.5 est passé de :
0,20 $ / 1 M de tokens
à :
0,10 $ / 1 M de tokens
Anthropic indique que les lectures du cache représentent une part importante de la consommation de tokens dans de nombreux workflows agentiques. Cette évolution réduit donc le coût de la plupart des tâches agentiques avec Sonnet 5.5 d’environ 20 %.
Cela rend une architecture combinant plusieurs modèles plus intéressante :
Sonnet 5.5
→ planification et exécution plus complexes

Haiku 5.5
→ sous-tâches volumineuses peu coûteuses
Anthropic a également introduit des crédits mensuels Claude Platform pour les abonnés Max et Team éligibles.
Les montants officiels actuels des crédits sont les suivants :
| Offre | Crédit API mensuel |
|---|---|
| Max 5x | 100 $ |
| Max 20x | 200 $ |
| Siège Team Standard | 20 $ par siège |
| Siège Team Premium | 100 $ par siège |
| Plafond mutualisé Team | 500 $ |
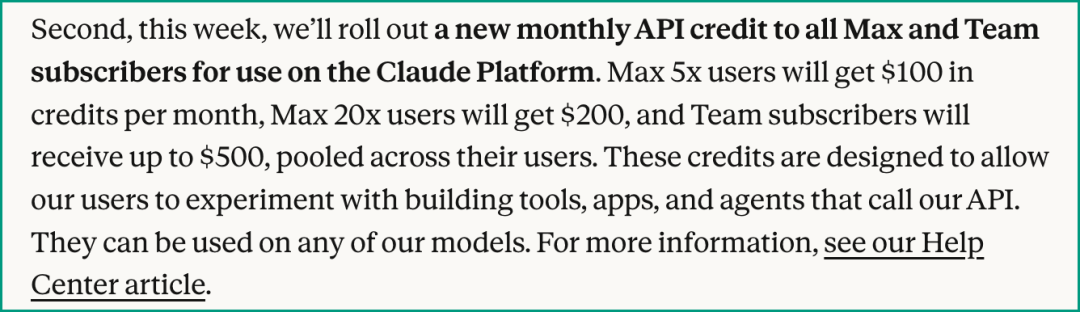
Les crédits peuvent être utilisés pour des charges de travail Claude Platform telles que :
Ils n’augmentent pas les limites d’utilisation de l’abonnement Claude ou Claude Code de l’utilisateur et ne couvrent pas les sessions Claude Code interactives habituelles lorsque ces sessions sont facturées via l’offre d’abonnement.
Les crédits sont associés à une seule organisation Claude Console et ne sont pas reportés indéfiniment.
La source se termine par une comparaison plus légère.
Alors qu’Anthropic annonçait des modèles moins chers, des lectures du cache Sonnet moins coûteuses et des crédits API mensuels, Thibault Sottiaux, responsable de Codex et de ChatGPT Work chez OpenAI, annonçait une nouvelle réinitialisation mise en réserve pour les comptes payants, tout en célébrant 40 millions d’utilisateurs actifs sur Codex et ChatGPT Work.
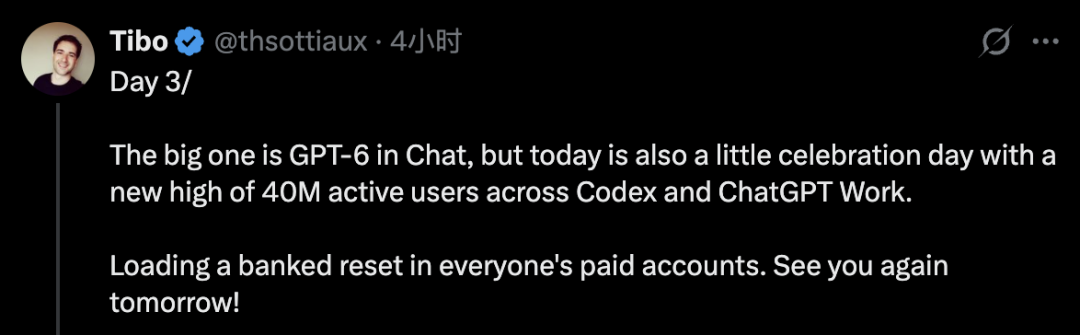
Une réinitialisation mise en réserve est différente d’une baisse de prix permanente.
Il s’agit d’une réinitialisation supplémentaire de l’utilisation, que les utilisateurs éligibles peuvent conserver et utiliser ultérieurement, et non d’une modification du tarif récurrent par token du modèle.
La comparaison est donc davantage rhétorique que technique :
Lancement Anthropic :
nouveau petit modèle + baisse du prix de lecture du cache + crédits API mensuels

Mise à jour OpenAI :
réinitialisation d’utilisation supplémentaire mise en réserve pour les comptes Codex / Work payants
Les deux entreprises cherchent à offrir davantage de marge d’expérimentation aux utilisateurs intensifs, mais elles utilisent des mécanismes différents.
Le lancement rend Haiku beaucoup plus utile, mais son rôle idéal reste relativement clair.
Utilisez Haiku 5.5 pour :
Préférez un modèle Claude plus puissant pour :
Le modèle le moins cher n’est pas toujours le moyen le moins coûteux de terminer une tâche.
Pour les systèmes en production, mesurez :
coût par tâche réussie
=
entrée + cache + sortie + utilisation des outils + nouvelles tentatives + échecs
Cette métrique vous en apprendra davantage que le seul tarif d’entrée affiché d’un modèle.
Claude Haiku 5.5 est le dernier petit modèle Claude d’Anthropic, conçu pour les charges de travail à grande échelle, sensibles au coût et à la latence. Il s’agit également du premier modèle Haiku doté d’un effort réglable. Il est nettement plus performant que Haiku 4.5 dans les évaluations liées au développement, à l’utilisation d’un ordinateur et aux tâches professionnelles.
Pour les prompts allant jusqu’à 100K tokens, le tarif est de 0,10 $ par million de tokens d’entrée et de 0,50 $ par million de tokens de sortie. Pour les prompts dépassant 100K, les tarifs passent à 0,50 $ pour l’entrée et 2,50 $ pour la sortie par million de tokens, avec des tarifs distincts pour la lecture et l’écriture du cache.
Pour la tarification standard des tokens avec un contexte court, les tarifs affichés pour l’entrée, l’entrée mise en cache, l’écriture du cache et la sortie sont pratiquement alignés. Le prix de Haiku 5.5 augmente au-delà du seuil de 100K tokens dans le prompt. Les charges de travail avec un long contexte doivent donc faire l’objet d’une comparaison distincte.
Non. Les propres résultats d’Anthropic sur Terminal-Bench 4.0 donnent 70,6 % à Sonnet 5.5, contre 39,2 % à Haiku 5.5. Haiku est mieux positionné pour les tâches ciblées, répétitives et volumineuses ainsi que pour le travail des sous-agents, tandis que Sonnet et Opus restent mieux adaptés au développement autonome complexe.
Haiku 5.5 utilise un tokenizer plus récent. Le guide de migration d’Anthropic indique qu’un même texte produit en moyenne environ 30 % de tokens supplémentaires avec Haiku 5.5 par rapport à Haiku 4.5, même si l’augmentation exacte dépend du contenu.
Oui. Les changements importants comprennent le raisonnement adaptatif à la place de budget_tokens, une nouvelle gestion des paramètres d’échantillonnage, la suppression du préremplissage de l’assistant, un nouvel ensemble d’outils pour l’utilisation de l’ordinateur et la nécessité d’analyser les blocs de réponse selon leur type. Anthropic fournit un guide officiel de migration ainsi qu’une commande de migration Claude Code.
Sur Claude API, l’identifiant du modèle est claude-haiku-5-5. Anthropic documente les identifiants correspondants pour Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform sur AWS.
Les abonnés Max et Team éligibles peuvent bénéficier de crédits mensuels Claude Platform. Max 5x reçoit 100 $, Max 20x reçoit 200 $ et les crédits Team sont calculés selon le type de siège, avec un plafond mutualisé de 500 $ par mois.
Claude Haiku 5.5 constitue une mise à niveau majeure de la gamme de petits modèles d’Anthropic. Il dépasse largement Haiku 4.5 en matière d’utilisation d’un ordinateur, de tâches professionnelles, de développement et de raisonnement, tout en affichant des tarifs API pour les contextes courts alignés sur ceux de GPT-6 Luna et en surpassant Luna dans plusieurs comparaisons de benchmarks publiées par Anthropic.
La baisse de prix est réelle, mais les équipes de production ne doivent pas négliger le nouveau tokenizer ni le seuil tarifaire de 100K tokens dans les prompts. Un même texte peut consommer environ 30 % de tokens supplémentaires par rapport à Haiku 4.5, et les prompts longs passent au niveau de tarification supérieur.
La migration comprend également de véritables changements incompatibles : le raisonnement adaptatif remplace les budgets de raisonnement manuels, les contrôles d’échantillonnage personnalisés sont limités, le préremplissage de l’assistant est supprimé et les intégrations d’utilisation de l’ordinateur doivent adopter le nouvel ensemble d’outils. Les applications Haiku 4.5 existantes doivent suivre le guide de migration plutôt que de modifier uniquement le nom du modèle.
Haiku 5.5 doit surtout être compris comme un modèle d’exécution rapide et économique pour les charges à grande échelle et les sous-agents, et non comme un remplacement universel de Sonnet ou Opus pour les tâches complexes à long horizon.
Partez d’une phrase et obtenez un site complet en quelques minutes.



